FOCUS
빅데이터는 우리가 모르는 것에 대해
얼마나 말해줄 수 있나
오세욱 | 한국언론진흥재단 책임연구위원
개인적으로 야구를 참 좋아한다. 한 팀을 30년 넘게 좋아하고 있는데 요새 성적이 별로라 최근에는 자주 보지는 않고 있다. 야구를 워낙 좋아했지만, 좋아하는 팀 성적에 따라 일희일비하는게 싫어 떠나려 한 적도 있었다. 그 시기 사회과학방법론 수업을 들었고 통계가 무엇인지 어렴풋이 알게 되었다.
숫자를 갖고 참 많은 것을 해석해 볼 수 있다. ‘머니 볼’이라는 영화를 본 다음에는 내가 배웠던 통계를 야구에 적용해 보는 재미에 빠지게 됐다. 야구 경기에서 측정된 모든 기록은 숫자로 남아 있기에 다양한 방식으로 계산하고 이를 바탕으로 향후 성적을 예측해 볼 수 있었다. 그런데 이 예측은 항상 빗나갔다. 분명히 통계적 예측 모델에 따르면 내가 좋아하는 팀의 성적은 최상위권이어야 했지만 결과는 항상 실망이었다. 야구의 기록은 정말 많은 것을 얘기해주지만 기록 외 변수가 너무 많았다. 예를 들어, 그 팀의 운영진, 감독과 선수들이 서로 얼마나 신뢰하는지는 숫자로 표현되지 않는다. 게다가 난 특정 한 팀을 너무 좋아해서 숫자를 우리 팀에 유리한 방향으로 해석하는 오류도 자주 범했다.
우리 대부분은 경험하고 있지만, 말로 하는 것보다 구체적인 숫자로 얘기할 때 상대방을 설득하기가 쉽다. 숫자는 말보다 정확하고 객관적이고 공정하다는 일반적 인식이 있기 때문이다. 데이터 중심 사회가 되면서 이러한 경향은 더욱 강해지고 있다. 우리가 알고 있는 대부분의 기업은 가능한 많은 데이터를 모으려고 한다. 소비자를 이해하고 설득하기 위한 가장 강력한 수단은 숫자이기 때문이다. 네이버 등 테크 기업들의 서비스를 이용하기 위해 회원 가입을 할 때 반드시 동의해야 하는 약관에는 수집하는 개인 정보 목록이 제시돼 있다. 뭐 이런 것까지 수집하나 할 정도로 상세하게 제시돼 있지만, 우리 대부분은 무심코 동의하고 있다. 이렇듯 상세하게 정보를 수집하는 이유는 하나다. 가능한 숫자를 많이 확보해야 그 사람의 행동을 예측하기 쉽고 이 예측에 따른 추천을 통해 자신들이 원하는 목적 달성이 쉬워지기 때문이다. 우리는 숫자로 이루어진 테크 기업들의 데이터베이스 속에서 무언가로 범주화되고 있다.
문제는 이 숫자가 그 사람을 정확히 보여주지 않는다는 점이다. 내가 야구를 얼마나 좋아하는지를 숫자로 표현하기는 어렵다. 나도 숫자로 표현하기 어려운 것이 제대로 수집될 수는 없다. 다만, 내가 얼마나 좋아하는지를 다양한 측정 방법을 통해 유추할 뿐이다. 야구 기사를 얼마나 봤고, 커뮤니티에는 얼마나 방문했고, 댓글을 달았는지, 내가 좋아하는 팀에 ‘좋아요’ 등을 클릭했는지 등을 수집한 뒤 이를 계량화해 숫자로 표현한다.
당연히 야구를 잘 아는 사람일수록 어디서 어떤 정보를 수집해야 하는지를 잘 안다. 야구를 좋아하는 사람만이 아는 경로들이 있기 때문이다. 제대로 된 숫자는 그 분야를 아는 사람이 가장 잘 알아본다. 같은 숫자를 보더라도 여러 갈래로 해석이 달라지는 이유이기도 하다. 매주 발표되는 지지율이 각자의 정치적 성향에 따라 달리 해석되는 것이 대표적이다.
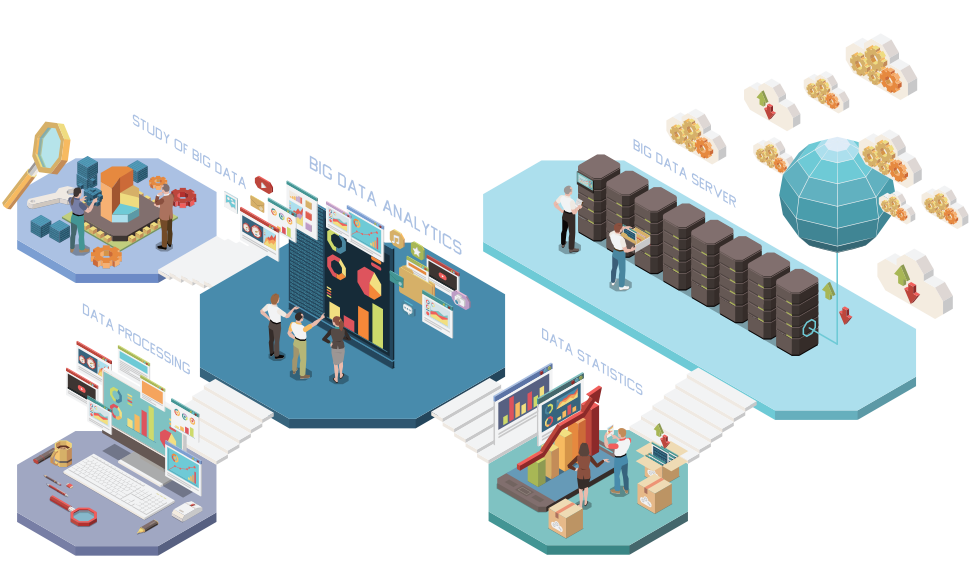
과학으로서 통계는 이러한 문제점을 해결하기 위해 신뢰도를 검증하여 얼마나 믿을 수 있는지를 수치화하고 해석할 때 유의할 점 등을 서술한다. 아무리 잘 설계한 조사를 실시하더라도 통계 결과는 놓치는 부분이 있을 수밖에 없다. 숫자가 모든 것을 말해주지 못하기 때문이다. 대한민국 인구주택 총조사 결과는 정말 많은 것을 제시해주지만 우리 국민 전체의 삶을 그대로 보여주고 있다고 말하기는 어렵다. 결국 해석이 필요하다.
해석에 있어 중요한 것은 지식과 경험이 해석에 있어서 중요한 것이 숫자가 놓치는 부분들을 간파하는 능력이다. 이는 사실 해석하는 사람이 그 분야에 대해 얼마나 지식과 경험을 갖고 있는지에 달려 있다. 지식은 쌓으면 어느 정도 해결할 수 있지만 경험은 다른 문제다. 남자와 여자의 삶은 아무리 감정이입을 하더라고 서로 다른 경험이 될 수 밖에 없다. 내가 좋아하는 야구 팀에 유리하게 통계모델을 적용하는 것처럼 각자 경험에 따라 같은 숫자도 다르게 해석하는 경우가 많다. 서울의 물가는 언론에서 지역의 물가보다 더 중요한 통계로 다뤄진다. 정말 많은 사람들이 아파트에 살고 있기에 거의 대부분의 부동산 가격 관련 기사는 아파트 매매가를 주로 다룬다. 2020년 ‘주거실태조사’ 통계에 따르면 아파트 거주 비율은 51.1%다. 언론에 보도 되는 각종 통계들은 그 통계를 다루는 언론 종사자들의 평균적 경험을 반영하는 경우가 많다. 엄마가 그렇게 부러워하는 ‘엄마 친구 아들 혹은 딸’은 통계 적으로 봤을 때 극히 작은 수이지만, 우리 대부분은 그 존재를 알고 있다.
이러한 해석의 문제를 해결할 수 있다는 주장 중 하나가 ‘빅데이터’다. 통계가 일반적으로 표본 추출을 통해 만들어지는데 반해 ‘빅데이터’는 표본이 아닌 전수에 가까운 수집을 하기 때문에 더 정확하고 더 많은 것을 말해준다고 한다.
‘빅데이터’는 정말 ‘빅’인가우리는 지금 데이터 시대를 살고 있다. 더 많은 데이터가 더 많은 사실들을 얘기해 줄 것이라는 일반적인 믿음이 우리 사회를 지배하고 있다. ‘빅데이터’ 라는 단어가 일상적으로 사용되고 있으며, 이 ‘빅데이터’가 기존에 인간이 갖고 있던 통찰력과 직관, 사고 능력을 뛰어넘어 더 많은 것을 얘기해주는 것처럼 간주되고 있다. 빅데이터 분석을 했다고 하면 더 나은 분석일 것이라는 일반적 믿음 아래에서 단순한 데이터 분석도 빅데이터 분석을 한 것처럼 포장되고 있기도 하다. ‘빅’이란 크다는 의미의 영어 형용사다. ‘빅데이터’는 우리 말로 풀자면 ‘큰 데이터’ 이다. 그런데 크다는 것이 얼마나 크다는 것인지 명확히 정의하기 어렵다. 전 세계 데이터 양은 매년 두 배 이상 증가하는 것으로 알려져 있지만, 그 증가 속도는 더욱 빨라지고 있다.1)
지난 2001년 미국의 시장조사 및 컨설팅 기업인 가트너(Gartner)가 내린 정의2)에 따르면, ‘빅데이터’ 는 전례 없이 빠른 속도로 쏟아져 나오는 다양한 종류의 데이터를 의미한다. ‘빅데이터’는 기술의 발전으로 새로운 데이터 출처로부터 수집된 큰 규모의 데이터 세트라고 할 수 있다. 하지만, 절대적 의미에서 ‘빅’은 정의할 수 없으며 이전보다 클 뿐이다.
빅데이터는 전체 세상 일부분에 대한 근사치제이콥스(Jacobs, 2009)3)는 이에 따라 “어떠한 지점에서든 그 당시 일반적이었으며 유효성이 증명된 (tried-and-true) 방식을 넘어서 바라볼 것을 강요하는 데이터”라고 ‘빅데이터’를 정의한다. ‘빅데이터’는 절대적이 아니라 상대적이며 시대에 따라 다르다. 1980년 초반에는 수천 개의 테이프를 자동으로 입출력할 수 있는 ‘테이프 몽키’가 필요했던 데이터였으며 1990년대에는 엑셀과 데스크톱 PC의 범위를 초월해 유닉스 워크스테이션 기반의 소프트웨어를 필요로 하는 데이터가 ‘빅데이터’라는 것이다. 지금은 DBMS에 넣어 데스크톱 환경의 통계 및 시각화 패키지의 도움으로 분석하기에는 너무나 큰 데이터를 의미한다. ‘빅데이터’는 현재 시점에서 큰 데이터일 뿐이지 모든 것을 말해주는 데이터가 아니다.
또한, 데이터가 아무리 크다 해도 한계가 있다. 기본적으로 데이터는 ‘연산가능성(computa-bility)’(Boyd & Crawford, 2012)4)을 기반으로 한다. 숫자화될 수 있어야 한다는 것으로 계산이 가능해야만 분석이 가능하다. ‘엄마를 얼마나 좋아해’라는 질문에 대한 답은 숫자로 정의될 수 없다. 모든 것을 아는 것처럼 보이는 ‘챗GPT’의 한계를 우리는 이미 체험하고 있다.
“챗GPT는 현재 웹의 흐릿한 그림(ChatGPT Is a Blurry JPEG of the Web)”5) 이라는 공상과학 작가 테드 창(Ted Chiang)의 지적처럼 이른바 ‘빅데이터’로 우리가 얻을 수 있는 것은 전체 세상 일부분에 대한 근사치에 불과하다. 숫자로 된 야구의 기록이 모든 것을 말해준다면 야구를 좋아할 필요가 없을 것이다. 야구는 ‘모르기’ 때문에 재미있다.
1) https://www.emc.com/leadership/digital-universe/2014iview/executive-summary.htm
2) https://www.gartner.com/en/information-technology/glossary/big-data
3) Jacobs, A. (2009). The Pathologies of Big Data. Communications of the Acm, 52(8), pp. 36-44.
4) Boyd, D., & Crawford, K. (2012). Critical questions for big data: Provocations for a cultural, technological, and scholarly phenomenon. Information Communication & Society, 15(5), 662-679.
5)Ted Chiang (2023. 2. 9.). ChatGPT Is a Blurry JPEG of the Web. The New Yorker. https://www.newyorker.com/tech/annals-of-technology/chatgpt-is-a-blurry-jpeg-of-the-web